
De etiquetas de QGIS a un detector de nueva construcción y un nuevo dataset en una hora
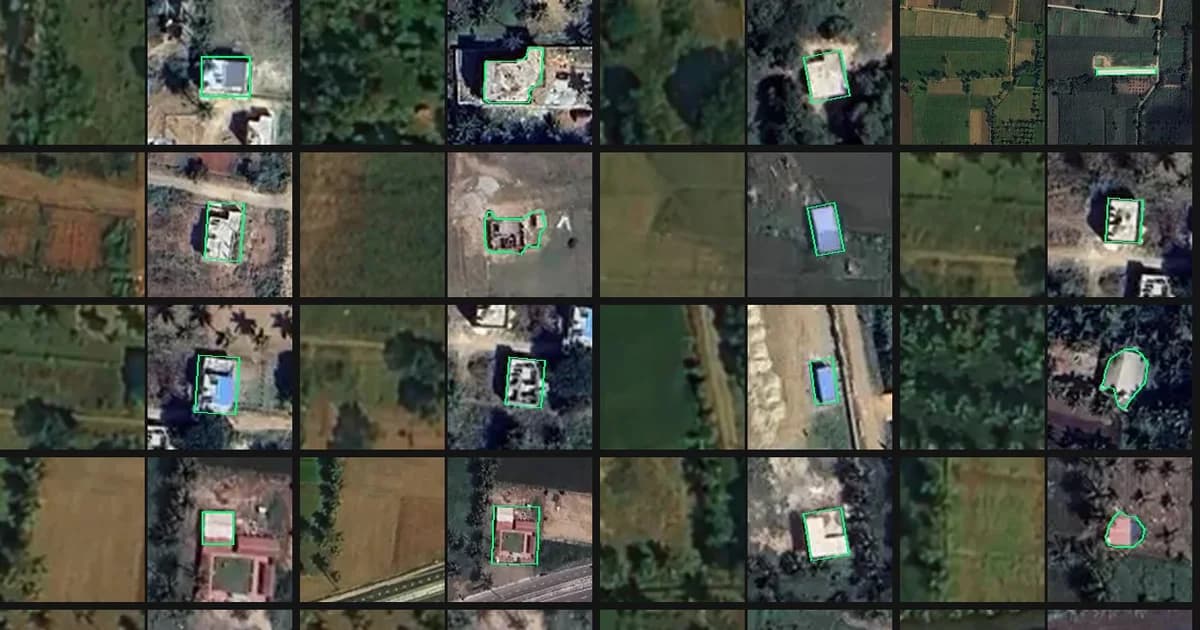
Seguimos experimentando con agentes de IA, y esta vez se trata de la validación cartográfica y la detección de construcción. Vale la pena decir que es otro flujo de trabajo disruptivo más en la cartografía con IA. En este experimento le dimos a un agente de IA un proyecto de QGIS con 487 polígonos dibujados a mano y le preguntamos: ¿son estas etiquetas lo bastante buenas para entrenar un detector de nueva construcción de baja altura? Unos 30 minutos después, había entrenado un clasificador de cambios con ellas y revisado cada etiqueta. Marcó el 10% de las etiquetas para eliminar o corregir y encontró edificios nuevos que nuestros cartógrafos habían pasado por alto.
La tarea
Proyecto preliminar
El área del proyecto estaba en Karnataka (India), de unos 9 × 8 km. Combina manzanas urbanas densas con aldeas, plantaciones de palmeras y tierras de cultivo. El objetivo es la nueva construcción de baja altura: sobre todo casas de una y dos plantas, cobertizos y parcelas recién despejadas.
- El dataset inicial se creó con el plugin de Mapflow para QGIS. Las obras se etiquetaron a mano como rectángulos (bbox) o envolventes convexas y luego se aplicó el modelo Mapflow Buildings para delinear los edificios dentro de esas áreas.
- A partir de los resultados de la anotación, estimamos la precisión posible del modelo de detección de construcción en ~70% para el 90% de las obras.
- Se esperaba que la clasificación de las obras por etapas fuera menos precisa y con un intervalo de confianza más amplio. Para aumentar esa precisión pedimos a los clientes imágenes más detalladas, como fotografía aérea, pero resultó costoso y no encajaba en el presupuesto del proyecto, así que abandonamos la idea.
El flujo de trabajo agéntico
La entrada para el agente fue:
- Un proyecto de QGIS (.qgz) con dos capas de imágenes: un mosaico global de 2023 («antes») y una nueva escena de alta resolución («después»).
- Un GeoJSON de 487 polígonos de cambio de construcción con un atributo
stage(completed / new / vacío). Solo 110 etiquetas tenían etapa, demasiado pocas para aprender de ellas, así que se pidió al clasificador que la ignorara y tratara todos los polígonos como una única clase «cambio de construcción».
El prompt fue una sola frase: usa estas etiquetas como etiquetas de entrenamiento para cambios de construcción, valídalas y encuentra las etiquetas que faltan o son falsas.
Qué hizo el agente
El agente leyó el proyecto, definió los pasos y escribió y ejecutó sus propios scripts.
- Leyó el proyecto de QGIS
- Descargó las imágenes
- Alineó las fechas. ¡Aquí está lo interesante! Las imágenes estaban desplazadas entre 3 y 8 m, y el desplazamiento variaba a lo largo de la escena. El agente midió el desplazamiento en una cuadrícula de ventanas y deformó el mosaico de 2023 sobre el nuevo, con lo que el error restante bajó a unos 0,8 m.
- Revisó cada etiqueta. Recortó un fragmento antes/después para cada uno de los 487 polígonos y los revisó en hojas de 28. Después volvió a abrir unos 90 casos dudosos a mayor tamaño.
- Entrenó un clasificador con las etiquetas. Pasó una ResNet-18 preentrenada por ambas fechas y entrenó una regresión logística con las características de las dos fechas y su diferencia. La evaluó en bloques espaciales que el modelo no había visto: AUC 0,96.
- Buscó lo que faltaba. Ordenó los lugares sin etiquetar según «parece construido ahora, parecía sin construir en 2023». Revisó uno por uno los 108 mejores candidatos y tomó muestras más abajo en la lista para estimar cuántos faltaban.
- Entregó los resultados. Generó un GeoJSON de las etiquetas con un
qa_flagpor polígono, una lista de candidatos omitidos y una página de informe con los fragmentos de imagen.
Qué encontró
De las 487 etiquetas, el 88% era correcto, y los problemas se agruparon en unos pocos patrones.
| Problema | Etiquetas | Cómo se ve |
|---|---|---|
| Ya construido en 2023 | 23 | La casa aparece en ambas imágenes, o no cambió nada |
| Solo cambio de tejado | 14 | Misma huella; un tejado verde pasó a azul, o uno rojo a naranja |
| Polígono demasiado grande | 9 | El recuadro abarca una casa antigua y su nueva ampliación; uno mide 2,4 ha |
| Demolición | 3 | Cobertizos retirados, nada construido |
| Dudoso | 8 | ¿Tejado sobre muros existentes o solo un cambio de tejado? La imagen de 2023 es demasiado borrosa |
El hallazgo más importante fue lo que faltaba. Entre los 108 mejores candidatos, el agente confirmó 39 edificios nuevos sin etiquetar y 29 obras o parcelas despejadas. Las muestras más abajo en la lista añadieron algunos más. Extrapolando las tasas de acierto, la escena probablemente contiene entre 100 y 200 edificios nuevos sin etiquetar, por lo que la exhaustividad (recall) del etiquetado de edificios ronda el 70–80%. Ojo: esto mide lo completas que están las etiquetas manuales, no la precisión del modelo, así que todavía no comprueba nuestra estimación preliminar de ~70%.
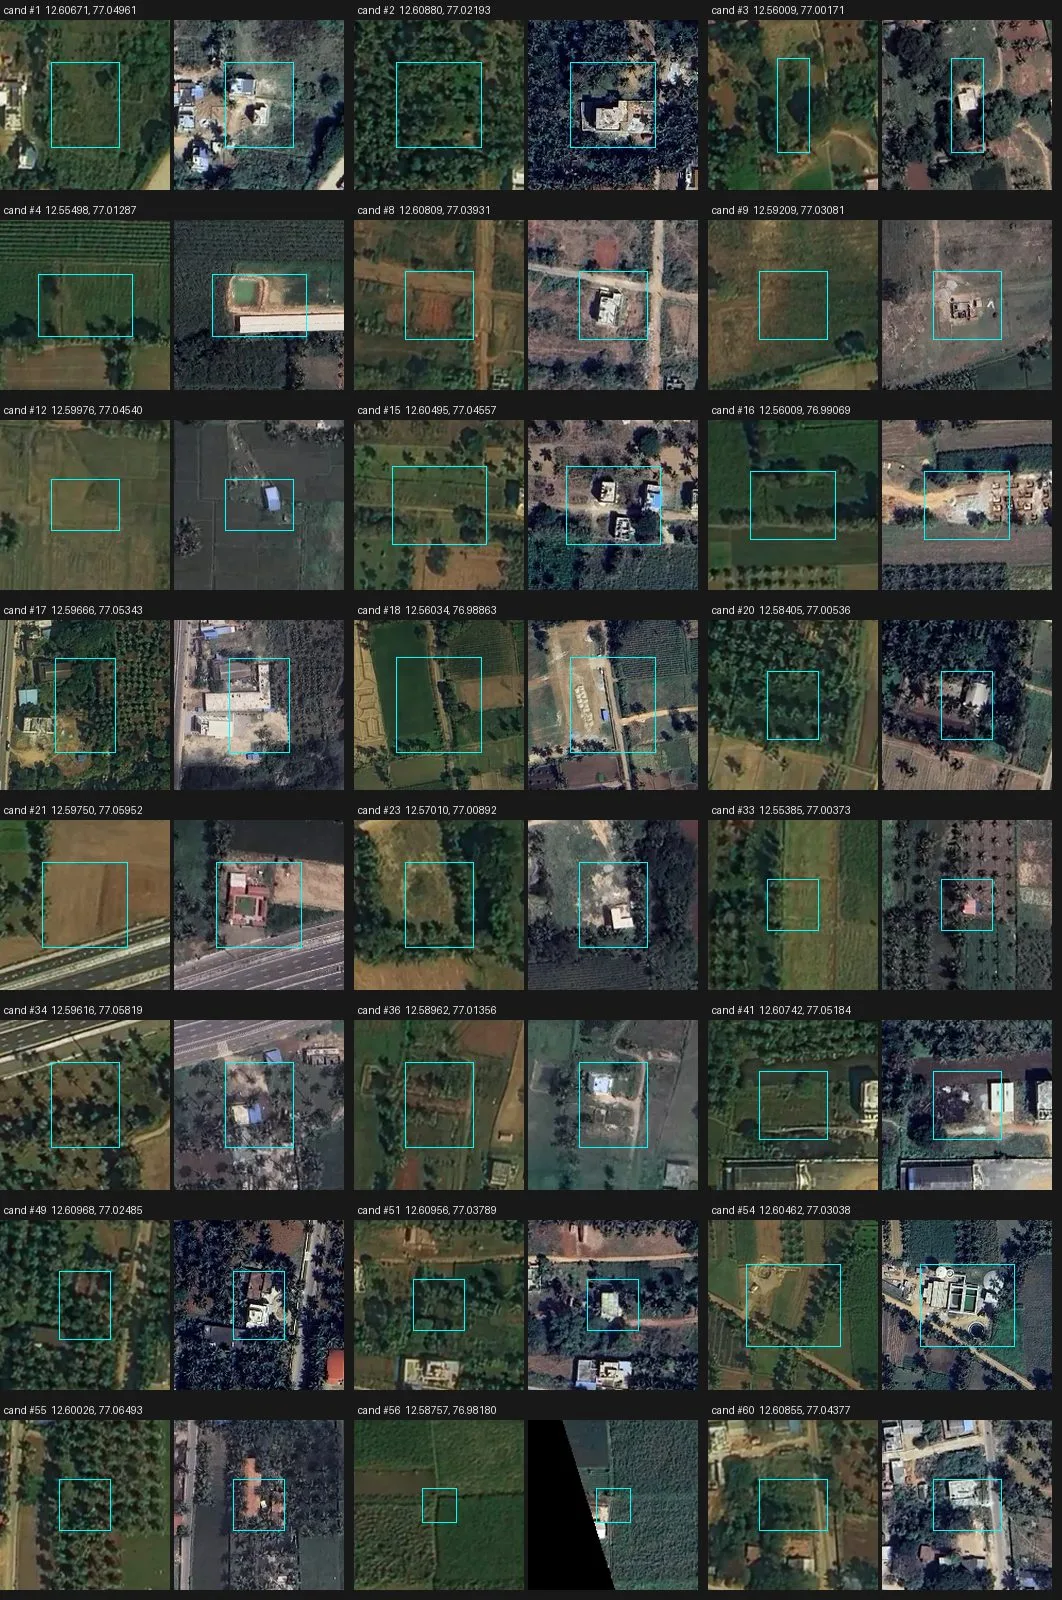
Edificios nuevos omitidos que encontró el clasificador. El recuadro cian marca el candidato: terreno vacío en 2023 (izquierda), una casa o cobertizo nuevo ahora (derecha).
Lo rural y lo urbano denso fallan de forma distinta
Los dos entornos estropean las etiquetas de maneras opuestas, así que un conjunto de entrenamiento debe cubrir ambos a propósito.
- Zonas rurales: omisiones. La mayoría de los edificios sin etiquetar eran casas aisladas en palmerales, cobertizos junto a campos y recintos nuevos en las afueras de aldeas. De las 42 omisiones confirmadas, 35 tenían menos de cinco etiquetas en un radio de 500 m, y la mayoría ninguna. Los anotadores se concentran donde hay muchos cambios y se saltan las teselas que parecen vacías: así estaba montado nuestro flujo de anotación en QGIS (alternar las capas de imagen antigua <> nueva y detectar la diferencia a ojo). Un modelo entrenado con eso aprende a ignorar la construcción aislada.
- Zonas urbanas densas: etiquetas falsas. Unas 9 de cada 10 etiquetas falsas o de solo tejado estaban en grupos densos, con cinco o más etiquetas en un radio de 500 m. Cuando los tejados están pegados, un tejado nuevo azul o una planta añadida parece un edificio nuevo (también es un factor del ojo humano), y la imagen borrosa de 2023 lo empeora.
- Los anotadores necesitan una norma escrita para los casos límite. Los cambios de tejado, las ampliaciones, las demoliciones y el despeje de terreno se etiquetaron en unos lugares y en otros no.
- Alinee las imágenes antes de recortar los fragmentos. Unos pocos metros de desfase convierten cada borde de una casa sin cambios en un falso píxel de «cambio». Esto pesa más en zonas densas, donde los edificios son pequeños y están pegados.
Cerrando el ciclo con Mapflow
Después, el agente añadió por sí mismo 45 edificios omitidos al conjunto de entrenamiento. Le llevó unos 12 minutos en una sesión de Mapflow SAM conectada mediante MCP.
- El agente colocó un punto en cada edificio omitido en las 42 ubicaciones confirmadas. La varita mágica de Mapflow delineó cada edificio a partir de su punto.
- El primer intento usó una escala gruesa de 2,3 m y dibujó contornos imprecisos. Cambiar la varita a 0,29 m lo solucionó. El agente ajustó este parámetro por sí mismo.
- Una hoja de control con todos los contornos detectó cuatro errores: un muro de recinto, un pavimento, una mancha oscura y suelo desnudo. El agente los eliminó y cuadró el resto en rectángulos.
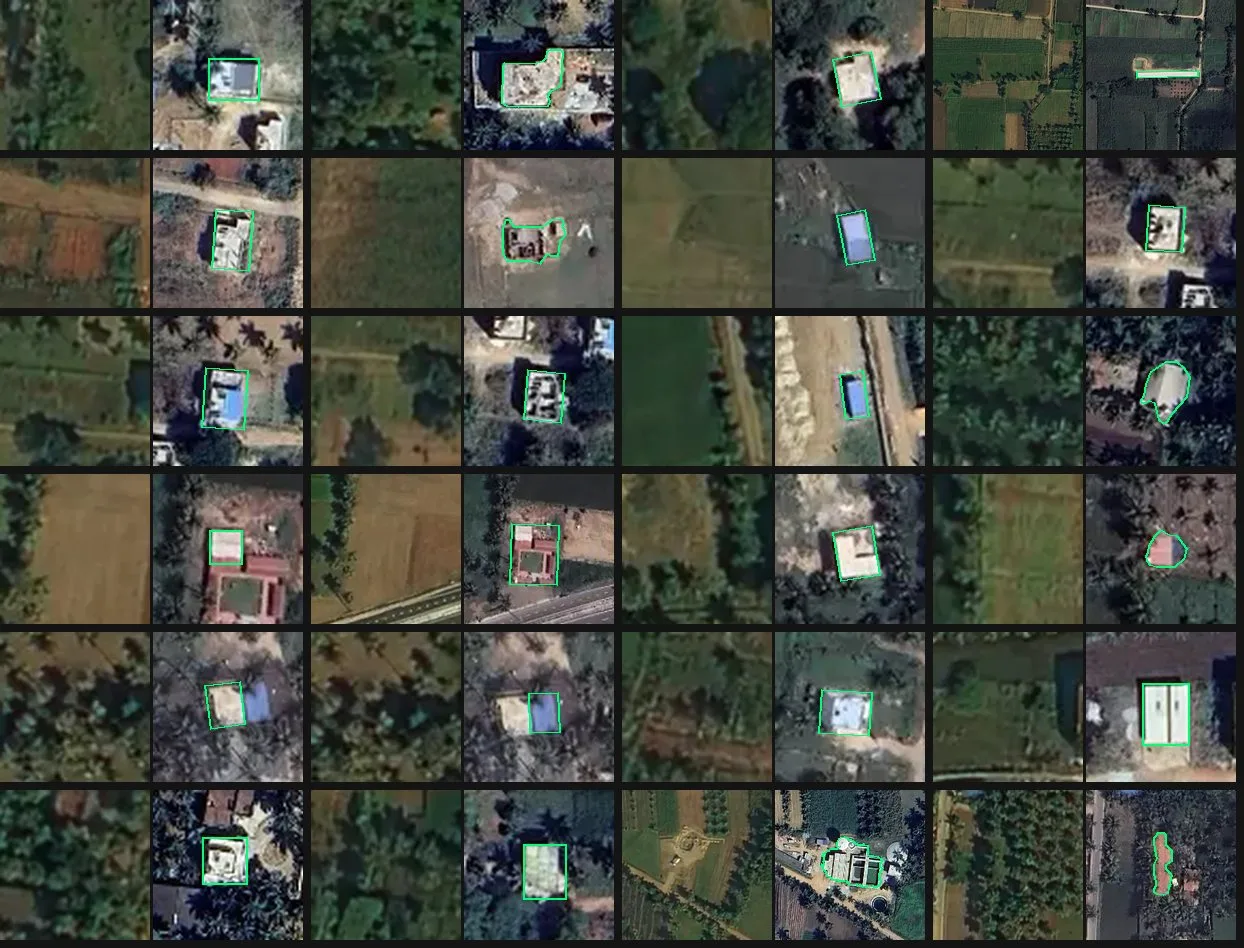
24 de las 45 nuevas huellas. Cada par muestra la imagen de 2023 a la izquierda y la nueva imagen con el contorno de Mapflow a la derecha.
El resultado se integra directamente en las etiquetas de entrenamiento: las 446 etiquetas conservadas tras la revisión más 45 huellas nuevas, 491 en total.
Esfuerzo, coste y próximos pasos
La ejecución del agente tardó unos 26 minutos y costó unos 6,30 $ en uso del modelo. Revisar 487 pares antes/después y recorrer 75 km² a mano en busca de omisiones les llevaría a nuestros anotadores un par de días o más.
Toda la sesión de revisión cartográfica costó unos 31 $. La tabla muestra el desglose por pasos, según el registro de uso de la sesión. El modelo es Claude Opus 5.5, uno de los más caros.
| Paso | Pasos del agente | Tokens ponderados por precio | Coste (USD) |
|---|---|---|---|
| Revisión de etiquetas: teselas, alineación, clasificador, revisión, informe | 73 | 2,28M | 6,31 |
| Huellas con Mapflow SAM (total) | 61 | 2,75M | 7,59 |
| Subir la imagen a Mapflow, preparar la sesión | 15 | 0,51M | 1,40 |
| Colocar puntos en 42 ubicaciones | 19 | 1,12M | 3,10 |
| Sesión SAM: varita, revisión, rectángulos, exportación | 17 | 0,68M | 1,89 |
| Actualizar el post y el documento del proyecto | 10 | 0,43M | 1,19 |
| Borrador del post | 13 | 0,73M | 2,01 |
| Cambios a partir de comentarios | 55 | 4,44M | 12,28 |
| Corrección del documento del proyecto | 5 | 0,61M | 1,67 |
| Consulta de uso | 8 | 0,30M | 0,82 |
| Total | 215 | 11,1M | ~31 |
La tabla solo cuenta el uso del modelo por parte del agente. La tarifa por superficie de Mapflow va aparte. A 1 $ por km² con un mínimo de 1 km², sería de unos 75 $ para toda la escena. Enviar solo ventanas de 200 m alrededor de los 42 edificios omitidos, como una única área multiparte, la reduce a unos 2 $. Delinear todos los edificios nuevos requiere alrededor del 5% de la superficie, 4 $ (véase la tabla de escalado).
¿Podría el agente haber delineado los 45 edificios sin SAM? Seguiría necesitando los puntos (3,10 $) y luego dibujar cada polígono a ojo y revisarlos y corregirlos en 2–3 rondas, unos 25 pasos más. Eso supone unos 6 $ en tokens, más o menos lo mismo que la vía SAM (5 $ en tokens más 2–4 $ de tarifa de Mapflow). La diferencia está en la calidad. Las esquinas colocadas a mano sobre imágenes de 0,58 m se desvían 1–2 píxeles, alrededor de 1 m, lo que supone un error de área de aproximadamente el 25% en una casa de 150 m². SAM ajusta los contornos a los bordes de los tejados.
Escalado a todo Karnataka
A escala estatal, el coste pasa casi por completo a la tarifa por superficie de Mapflow. Los tokens del agente se convierten en un coste fijo pequeño, y eso depende de tres optimizaciones:
- La detección de cambios se ejecuta como código. El clasificador entrenado se ejecuta como código normal, sin el agente en el bucle. Las características llevaron unos 340 segundos de CPU para esta escena de 75 km², unos 4,5 s por km².
- El agente solo revisa. Comprueba una muestra de unas 200 detecciones por distrito en lugar de cada etiqueta.
- SAM solo ve ventanas de cambio. El delineado se ejecuta sobre ventanas de 100 m alrededor de las detecciones, enviadas como una única área multiparte por distrito. Sin clics de varita edificio por edificio.
En Maddur, las ventanas de 100 m cubren el 5% de la superficie para los edificios realmente nuevos y el 16% para todo lo que marca el detector actual. La tabla supone que el 5% de la superficie va a Mapflow: ventanas de 100 m alrededor de todos los edificios nuevos, cada distrito enviado como una única área multiparte. Los 42 edificios omitidos por sí solos necesitaron el 2%.
| Escala | Superficie (km²) | Superficie enviada a Mapflow (5%) | Cómputo de detección | Tarifa de Mapflow a 1 $/km² | Tokens del agente | Total | Por km² |
|---|---|---|---|---|---|---|---|
| Esta prueba (Maddur) | 75 | 3,8 km² (se factura 4) | < 0,01 $ | 4 $ | 11 $ | 15 $ | 0,20 $ |
| Un distrito (media) | 6.200 | 310 km² | ~1 $ | 310 $ | ~10 $ | ~321 $ | 0,052 $ |
| Karnataka (31 distritos) | 191.800 | 9.590 km² | 30–50 $ | 9.590 $ | ~350 $ | ~9.980 $ | 0,052 $ |
| Comparación: todo el estado enviado a Mapflow | 191.800 | 191.800 km² | 30–50 $ | 191.800 $ | ~350 $ | ~192.200 $ | 1,00 $ |
A escala estatal, los tokens del agente suman unos 20 $ para construir y reentrenar el pipeline, más unos 10 $ por distrito para la revisión por muestreo y la ejecución de Mapflow. Ejecutar la revisión completa del agente escena por escena costaría unos 16.000 $ (2.560 escenas × 6,30 $). No se incluyen las imágenes. Tampoco el coste de reentrenar para aumentar la precisión del detector, lo que reduce las ventanas y la tarifa.
Conclusiones
Más que conclusiones, esto es una instantánea de nuestros experimentos actuales con una tecnología que cambia muy rápido.
El flujo de trabajo agéntico que aprovecha GPU escalables con un modelo abierto (el caso de Mapflow) es un método potente para tareas de validación cartográfica que consumen mucho tiempo: más preciso y rápido que el agente en solitario, a un coste similar. A escala estatal, el flujo optimizado es aproximadamente 1,6 veces más barato que ejecutar el agente escena por escena (10.000 $ frente a 16.000 $) y unas 20 veces más barato que procesar todo Karnataka con Mapflow. ¡Una diferencia enorme!
No excluye al cartógrafo; lo pone en otro papel: anotador + supervisor. El siguiente paso es reentrenar con los pares limpios y alineados y repetir la misma auditoría para medir la mejora en los nuevos territorios.
Escribir este post nos llevó más tiempo que entrenar un clasificador y ejecutar el pipeline agéntico (sin contar la anotación inicial de las imágenes).
Vivimos un tiempo de cambios transformadores, nada sorprendente. Lo que aún nos sorprende es lo rápido que avanzan.
¡Feliz cartografía! 🗺️